Agent Claude et workflow agentique : le quoi, le comment, le pourquoi
Depuis que Claude Code s'est installé dans mon quotidien, la question qu'on me pose le plus souvent n'est pas « c'est quoi l'IA générative », mais « c'est quoi exactement un agent, et comment je fais pour en construire un ». Les deux questions se confondent souvent avec « comment mieux utiliser un chatbot », alors qu'il s'agit d'un modèle d'exécution complètement différent. Cet article répond aux trois : le quoi, le pourquoi, et le comment, avec du code à chaque étape.
Le quoi : un agent, c'est une boucle#
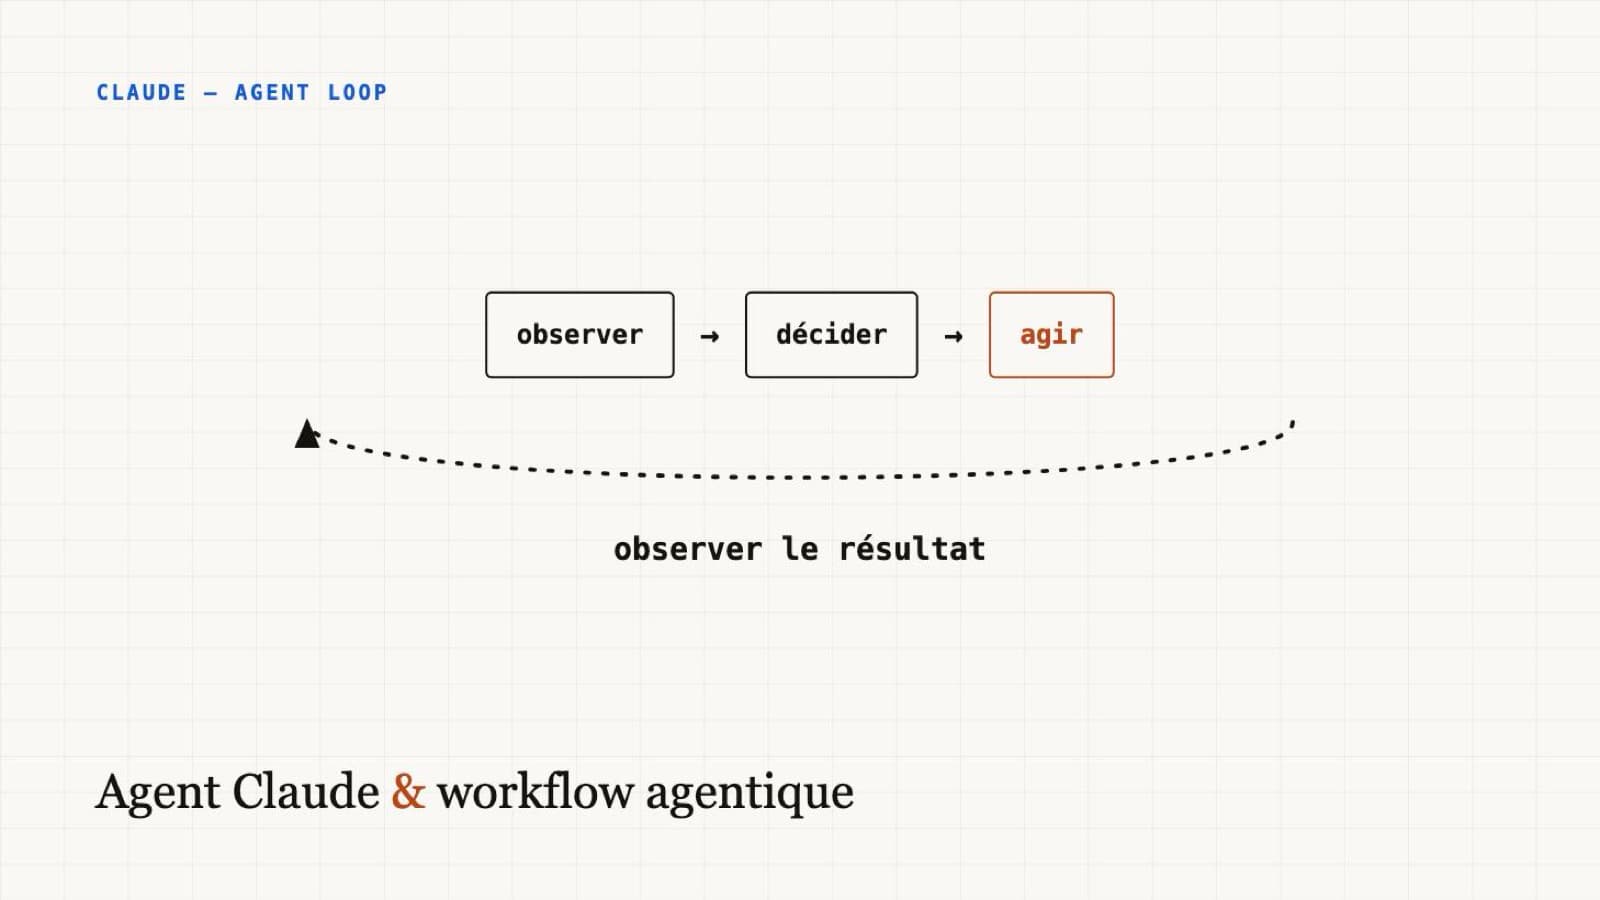
Un appel classique à un modèle de langage, c'est une fonction pure : un texte en entrée, un texte en sortie, une seule fois. Un agent, c'est autre chose : c'est une boucle qui observe un contexte, décide d'une action, l'exécute, observe le résultat, et recommence, jusqu'à ce que la tâche soit terminée.
observer ──▶ décider ──▶ agir ──▶ observer le résultat
    ▲                                      │
    └──────────────────────────────────────┘
Concrètement, « agir » veut dire appeler un outil : lire un fichier, exécuter une commande, interroger une API. Le modèle ne se contente plus de répondre, il peut vérifier ce qu'il vient de faire et corriger le tir avant de rendre la main. C'est cette capacité à boucler sur l'action et l'observation qui distingue un agent d'un simple appel API, pas la taille du prompt ni le nombre de tokens envoyés.
J'ai déjà détaillé la distinction entre l'agent (la boucle, probabiliste), le harnais qui l'entoure (déterministe) et les skills chargés à la demande dans un article dédié. Ici, je me concentre sur la boucle elle-même : ce qu'elle est et comment on la code.
Le pourquoi : pourquoi ne pas juste faire un plus gros prompt#
La tentation, face à une tâche complexe, est d'écrire un prompt de plus en plus détaillé pour couvrir tous les cas à l'avance. Ça ne marche pas au-delà d'un certain point, pour une raison simple : un prompt, aussi bon soit-il, ne peut pas contenir une information que le modèle n'a pas encore, comme le contenu réel d'un fichier ou le résultat d'une commande qui n'a pas encore tourné.
| Besoin | Un seul appel API | Un agent |
|---|---|---|
| Classifier, résumer, extraire une info connue à l'avance | Suffit, plus rapide et moins cher | Inutile, juste plus lent |
| Corriger du code jusqu'à ce que les tests passent | Impossible : le modèle ne voit jamais le résultat des tests | Naturel : la boucle relance les tests après chaque correction |
| Répondre à une question sur un repo qu'on n'a pas encore lu | Il faut tout coller dans le prompt à l'avance | L'agent lit les fichiers pertinents lui-même, à la demande |
La bonne question n'est pas « est-ce que je peux le faire avec un agent », c'est « est-ce que la tâche a besoin d'informations que je ne connais pas avant de commencer ». Si la réponse est non, un simple appel API fait le travail, en moins cher et plus prévisible. Un agent n'est pas un « amélioration » d'un appel API, c'est un outil différent pour un problème différent.
Le comment : construire un agent minimal#
Voici un agent complet, en TypeScript, avec un seul outil : lire un fichier. C'est volontairement le cas le plus simple possible, pour voir la mécanique sans qu'elle se noie dans les détails.
import Anthropic from "@anthropic-ai/sdk";
import { readFileSync } from "fs";

const client = new Anthropic();

const tools: Anthropic.Tool[] = [
  {
    name: "read_file",
    description: "Lit le contenu d'un fichier du projet",
    input_schema: {
      type: "object",
      properties: { path: { type: "string" } },
      required: ["path"],
    },
  },
];

function executeTool(name: string, input: any): string {
  if (name === "read_file") {
    return readFileSync(input.path, "utf-8");
  }
  throw new Error(`Outil inconnu : ${name}`);
}

let messages: Anthropic.MessageParam[] = [
  { role: "user", content: "Le package.json dépend-il de React ?" },
];

while (true) {
  const response = await client.messages.create({
    model: "claude-opus-5",
    max_tokens: 4096,
    tools,
    messages,
  });

  messages.push({ role: "assistant", content: response.content });

  if (response.stop_reason === "end_turn") {
    const text = response.content.find((b) => b.type === "text");
    console.log(text?.type === "text" ? text.text : "");
    break;
  }

  if (response.stop_reason !== "tool_use") break;

  const toolResults: Anthropic.ToolResultBlockParam[] = [];
  for (const block of response.content) {
    if (block.type === "tool_use") {
      toolResults.push({
        type: "tool_result",
        tool_use_id: block.id,
        content: executeTool(block.name, block.input),
      });
    }
  }
  messages.push({ role: "user", content: toolResults });
}readFileSync(input.path, ...) lit un chemin choisi par le modèle, pas par
toi : c'est une sortie non fiable, au même titre que n'importe quelle entrée
utilisateur. Dans un vrai projet, il faut résoudre ce chemin et vérifier qu'il
reste dans le dossier attendu avant de l'ouvrir, sous peine de laisser
l'agent lire (ou écrire, si l'outil le permet) n'importe où sur le
disque.
Le point essentiel est dans le while (true) : tant que stop_reason vaut
tool_use, le modèle a demandé une action, le code l'exécute, et le résultat
repart dans la conversation. La boucle ne s'arrête que quand le modèle décide
qu'il a assez d'informations pour répondre : end_turn. Rien de magique,
c'est une boucle de contrôle classique, avec un modèle de langage comme
composant de décision à la place d'une suite de if.
Pour un vrai projet, je pars du tool runner du SDK
(client.beta.messages.toolRunner) plutôt que de cette boucle manuelle : il
gère l'exécution des outils et l'enchaînement des tours à ma place. La boucle
manuelle reste utile pour comprendre ce qui se passe dessous, ou quand on a
besoin d'un contrôle que le tool runner n'offre pas.
Trois cas d'usage utiles pour un développeur#
Le même mécanisme, appliqué à trois besoins concrets que je rencontre régulièrement.
Corriger du code jusqu'à ce que les tests passent. L'outil exécute la suite de tests et renvoie stdout/stderr comme résultat. L'agent lit l'échec, propose une correction, relance les tests, et recommence jusqu'au vert ou jusqu'à une limite d'itérations. J'ai détaillé cette approche, avec ses pièges sous deadline, dans un article sur le vrai TDD avec Claude Code.
Répondre à une question sur un repo sans tout charger d'avance. C'est
exactement l'agent minimal ci-dessus, étendu avec un outil de recherche
(grep, ou une recherche par nom de fichier). Utile pour une question du
genre « où est gérée l'authentification » sur un repo qu'on ne connaît pas par
cœur.
Vérifier un déploiement avant de répondre à un client. L'outil appelle une API externe (ici, l'API Vercel) plutôt qu'un fichier local. L'agent peut enchaîner « lister les déploiements récents » puis « lire les logs du dernier échec » sans que j'aie à deviner à l'avance quelles informations seront utiles. C'est le rôle que joue MCP quand l'outil est déjà exposé par un serveur existant plutôt que codé à la main.
Dans les trois cas, le point commun n'est pas la complexité du code, qui reste minime : c'est que la tâche a besoin d'une information qu'on n'a pas encore au moment d'écrire le prompt. C'est ce besoin qui justifie la boucle, pas l'envie d'utiliser un agent parce que c'est le mot à la mode du moment.
Ce que ça généralise#
Un agent n'est ni plus intelligent ni plus fiable qu'un simple appel API : il a juste accès à plus d'informations, obtenues au fur et à mesure plutôt que devinées à l'avance. Cette différence a un coût (plus de tours, plus de tokens, plus de temps) qu'il faut mettre en face du problème réel : est-ce que la tâche est réellement ouverte, ou est-ce que je peux répondre avec un seul appel bien informé. La question à se poser avant d'écrire la première ligne de boucle reste toujours la même : qu'est-ce que je ne sais pas encore au moment de commencer, et qui ne peut venir que d'une action.