Kafka : diagnostiquer un consumer lag, méthodiquement
Une alerte tombe : « consumer lag élevé sur le groupe facturation ». Les
notifications partent avec vingt minutes de retard. Le réflexe le plus
répandu est d'augmenter le nombre de réplicas du consommateur. Il marche
dans un cas précis, ne change rien dans plusieurs autres, et aggrave la
situation dans au moins un. Cet article propose une démarche pour
diagnostiquer un lag avant de toucher à quoi que ce soit.
Ce que mesure le lag#
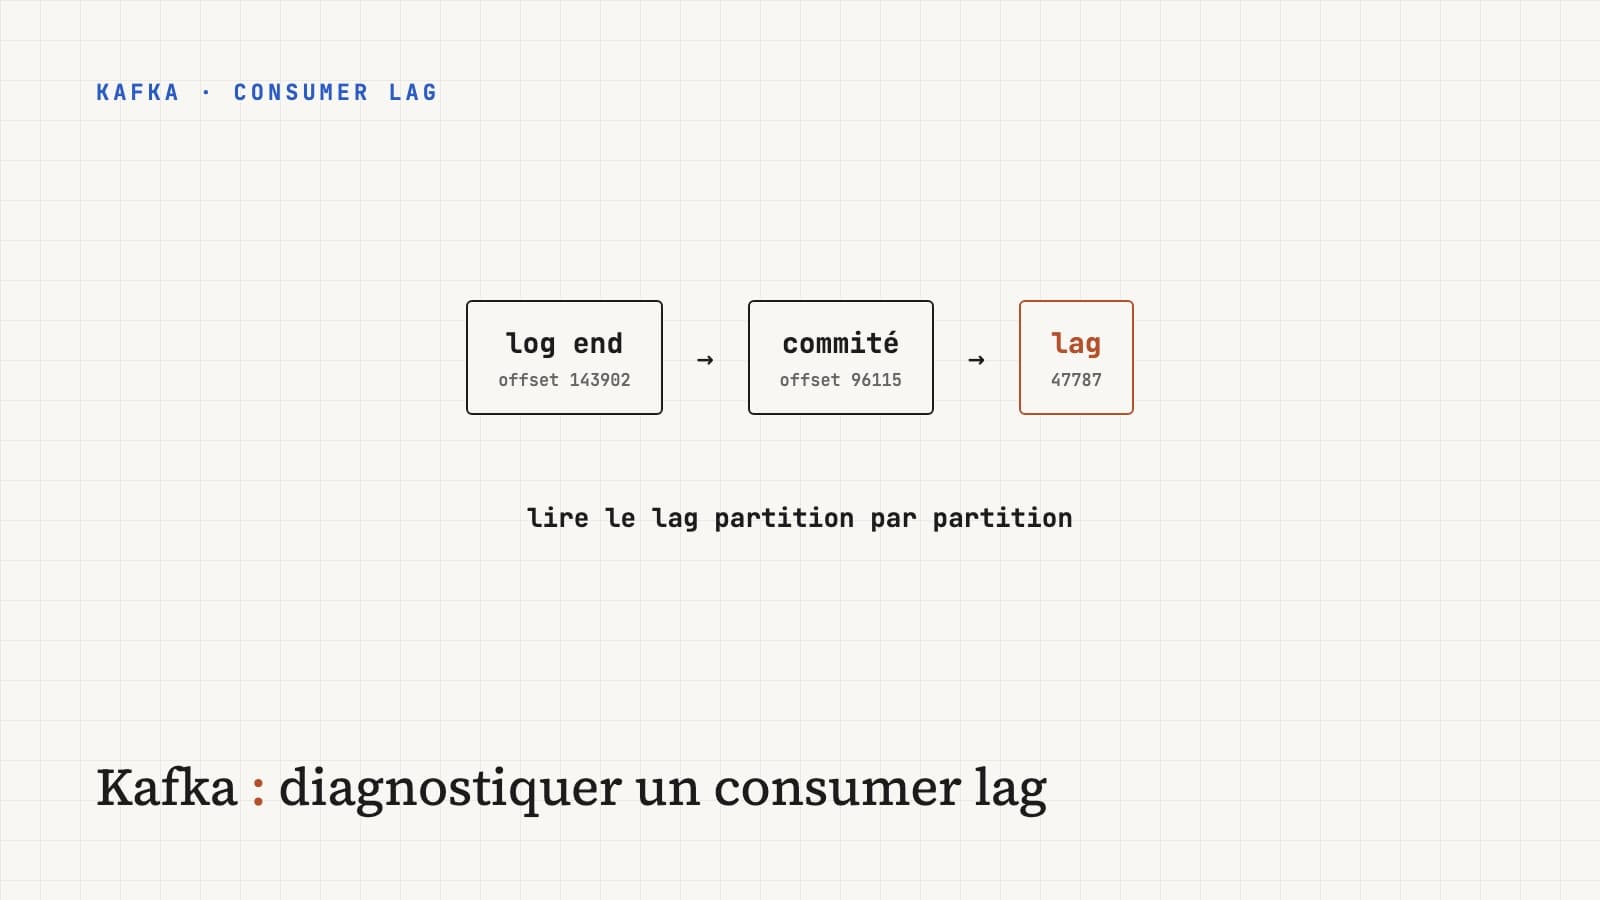
Pour chaque partition, Kafka connaît deux positions : le dernier offset écrit par les producteurs (le log end offset) et le dernier offset commité par le groupe de consommateurs. Le lag est la différence entre les deux.
partition 0 :  [0][1][2][3][4][5][6][7][8][9]
                            ▲              ▲
                     offset commité    log end offset
                            └── lag = 5 ───┘
Deux remarques qui évitent de mauvaises conclusions.
Le lag se lit par partition, pas en total. Un lag total de 50 000 peut être réparti équitablement sur 12 partitions, ou concentré à 49 000 sur une seule. Ce sont deux problèmes différents.
Un lag en nombre de messages ne dit pas grand-chose seul. 10 000 messages de retard sur un topic qui en reçoit 100 000 par seconde, c'est un dixième de seconde. Sur un topic qui en reçoit 10 par minute, c'est deux semaines. Ce qui compte pour l'utilisateur, c'est le retard en temps, et surtout sa tendance : un lag stable, même élevé, veut dire que le consommateur suit le rythme. Un lag qui croît en continu veut dire qu'il consomme moins vite que ce qui arrive, et qu'il ne rattrapera jamais sans changement.
Première étape : regarder le groupe#
La commande livrée avec Kafka donne presque tout ce qu'il faut :
kafka-consumer-groups.sh --bootstrap-server kafka:9092 \
--describe --group facturationTOPIC PARTITION CURRENT-OFFSET LOG-END-OFFSET LAG CONSUMER-ID HOST
factures 0 184220 184231 11 consumer-1-a3f… /10.0.1.12
factures 1 179804 179810 6 consumer-1-a3f… /10.0.1.12
factures 2 96115 143902 47787 consumer-2-7c1… /10.0.1.17
factures 3 181377 181390 13 consumer-3-e08… /10.0.1.21
Cette sortie oriente déjà le diagnostic. Ici, une seule partition est en retard, et les autres suivent. Ce n'est pas un problème de capacité globale.
Trois formes reviennent presque toujours :
| Ce qu'on voit | Piste principale |
|---|---|
| Toutes les partitions en retard, lag qui croît partout | Le traitement est globalement trop lent pour le débit |
| Une ou deux partitions en retard, les autres à jour | Clé chaude ou message problématique sur ces partitions |
Colonne CONSUMER-ID vide, ou qui change d'une exécution à l'autre | Le groupe est instable : rebalances en boucle |
Cas 1 : le traitement est trop lent#
Le consommateur passe son temps à traiter, et le débit entrant dépasse ce qu'il peut absorber. Avant d'ajouter des réplicas, il faut savoir où passe le temps. Dans la grande majorité des cas, ce n'est pas Kafka, c'est ce que le consommateur fait de chaque message : une requête SQL par message, un appel HTTP synchrone, une sérialisation coûteuse.
Les leviers, dans l'ordre où je les essaie :
- Mesurer le temps de traitement par message. Un simple timer autour du traitement suffit. Si un message prend 40 ms et qu'il en arrive 50 par seconde et par partition, le calcul est vite fait : le consommateur ne peut pas suivre.
- Traiter par lots.
max.poll.records(500 par défaut) détermine combien de messages arrivent à chaquepoll. Un insert en base de 500 lignes coûte beaucoup moins cher que 500 inserts d'une ligne. - Ajouter des consommateurs, mais seulement jusqu'au nombre de partitions. Dans un groupe, une partition est lue par un seul consommateur à la fois. Avec 4 partitions, un cinquième consommateur reste inactif.
- Augmenter le nombre de partitions, si on a atteint la limite du point 3. C'est une opération à planifier : pour un topic avec des clés, ajouter des partitions change la partition cible de chaque clé, et donc l'ordre de traitement pendant la transition.
Paralléliser à l'intérieur d'un consommateur (un pool de threads qui traite
les messages d'un même poll en parallèle) augmente le débit, mais casse
l'ordre par partition et complique la gestion des offsets : on ne peut
commiter un offset que lorsque tous les messages précédents sont traités.
Des bibliothèques comme Confluent Parallel Consumer le font correctement.
Le coder à la main est une source classique de pertes de messages.
Cas 2 : une partition en retard#
Quand une seule partition traîne, ajouter des consommateurs ne sert à rien : cette partition reste lue par un seul d'entre eux. Deux causes dominent.
Une clé chaude. Kafka envoie tous les messages d'une même clé dans la
même partition, pour garantir leur ordre. Si 40 % du trafic concerne un
seul client (un gros compte, un identifiant par défaut comme "unknown", ou
une clé nulle mal gérée), sa partition reçoit 40 % du trafic. On le
vérifie en comptant les messages par clé sur un échantillon. La correction
touche au modèle : choisir une clé plus fine si l'ordre n'est nécessaire
qu'à un niveau plus fin, ou isoler le gros client dans un topic dédié.
Un message qui bloque. Un message mal formé, trop gros, ou qui
déclenche une erreur que le consommateur réessaie indéfiniment. Le lag de la
partition croît pendant que CURRENT-OFFSET ne bouge plus du tout. C'est le
signe le plus clair : l'offset figé. La réponse est une politique d'erreur
explicite : un nombre limité de tentatives, puis l'envoi du message dans un
topic d'erreurs (dead letter topic) pour analyse, et le consommateur
continue. Spring Kafka le propose avec DefaultErrorHandler et
DeadLetterPublishingRecoverer.
Cas 3 : les rebalances en boucle#
C'est le cas où ajouter des consommateurs aggrave les choses. Un rebalance redistribue les partitions entre les membres du groupe. Pendant qu'il a lieu, la consommation s'arrête (complètement avec le protocole historique, partiellement avec le protocole coopératif). S'il se produit toutes les quelques minutes, le groupe passe plus de temps à se réorganiser qu'à consommer.
La cause la plus fréquente est un traitement plus long que
max.poll.interval.ms (5 minutes par défaut). Le consommateur n'appelle
pas poll à temps, le coordinateur le considère comme mort et l'exclut du
groupe. Ses partitions sont réattribuées, les messages non commités sont
relus par un autre consommateur, qui prend autant de temps, et le cycle
recommence.
poll() → 500 messages × 800 ms = 400 s de traitement
       → dépasse max.poll.interval.ms (300 s)
       → le consommateur est exclu, rebalance
       → les 500 messages sont relus ailleurs → même durée → nouveau rebalance
Les signes : des logs contenant Member ... leaving group ou Attempt to heartbeat failed since group is rebalancing, et une colonne CONSUMER-ID
qui change d'une exécution de la commande à l'autre.
Les corrections :
- réduire
max.poll.recordspour que chaque lot tienne largement dans le délai ; c'est le correctif le plus rapide ; - accélérer le traitement (cas 1) ;
- augmenter
max.poll.interval.ms, en dernier recours, car un consommateur réellement bloqué mettra plus longtemps à être détecté ; - passer au rebalance coopératif (
CooperativeStickyAssignor) pour que seules les partitions déplacées s'arrêtent, et utiliser l'appartenance statique (group.instance.id) pour qu'un redémarrage de pod pendant un déploiement ne déclenche pas de rebalance s'il revient à temps.
Les pauses de GC longues produisent le même symptôme, par un autre chemin : une JVM figée plusieurs secondes n'envoie plus de heartbeats. Si les rebalances coïncident avec des pics mémoire, c'est vers la JVM qu'il faut regarder.
Surveiller avant l'alerte#
La commande kafka-consumer-groups.sh sert au diagnostic, pas à la
surveillance. En continu, deux sources :
- côté consommateur, la métrique JMX
records-lag-max, exposée automatiquement par le client Java et reprise par Micrometer dans une application Spring Boot ; - côté cluster, un exporter Prometheus qui calcule le lag de tous les groupes sans dépendre des consommateurs, ce qui reste utile quand ils sont tous arrêtés.
Pour l'alerte, je préfère une règle sur la tendance plutôt qu'un seuil fixe : « le lag de ce groupe augmente depuis 15 minutes » plutôt que « le lag dépasse 10 000 ». Le seuil fixe réveille la nuit pour un pic que le consommateur aurait rattrapé seul en deux minutes, et reste silencieux sur un topic à faible débit où 500 messages représentent une journée de retard.
La démarche en résumé#
Le lag monte
 ├─ sur toutes les partitions ?
 │    └─ temps de traitement par message × débit > capacité → lots, puis réplicas (≤ partitions)
 ├─ sur une partition ?
 │    ├─ offset figé → message bloquant → retry limité + dead letter topic
 │    └─ offset qui avance lentement → clé chaude → revoir la clé
 └─ consommateurs qui changent / logs de rebalance ?
      └─ traitement > max.poll.interval.ms → réduire max.poll.records, coopératif, statique
Un lag n'est pas un problème de Kafka, c'est un symptôme. Kafka fait
exactement ce qu'on lui demande : il garde les messages en attendant qu'on
les lise. La cause se trouve presque toujours dans le consommateur ou dans
le choix des clés, et la commande --describe, lue partition par partition,
suffit à savoir dans quelle branche de l'arbre on se trouve.