OOMKilled ou OutOfMemoryError : où passe la mémoire d'une JVM dans un pod
Le scénario est classique. Un service Spring Boot tourne dans un pod limité
à 1 Gi, avec -XX:MaxRAMPercentage=75, comme recommandé dans
l'article sur Kubernetes au quotidien.
Les métriques montrent un tas qui plafonne à 500 Mo. Et pourtant, deux fois
par jour, le pod redémarre. kubectl describe pod affiche OOMKilled, code
de sortie 137. Aucune OutOfMemoryError dans les logs, aucun heap dump.
Ce n'est pas une contradiction : la JVM et Kubernetes ne mesurent pas la même mémoire. Cet article explique la différence entre les deux erreurs, où passe la mémoire qui n'est pas dans le tas, comment la mesurer, et comment en tirer des requests et limits cohérentes.
Deux erreurs, deux mécanismes#
OutOfMemoryError | OOMKilled | |
|---|---|---|
| Qui la déclenche | La JVM | Le noyau Linux (cgroup du conteneur) |
| Ce qui est plein | Le tas (ou le metaspace, ou la mémoire directe) | La mémoire totale du processus a dépassé la limite du conteneur |
| Ce qu'on obtient | Une exception, une stack trace, un heap dump si configuré | Un processus tué net, code de sortie 137 (128 + SIGKILL) |
| Où regarder | Les logs de l'application | kubectl describe pod, champ Last State |
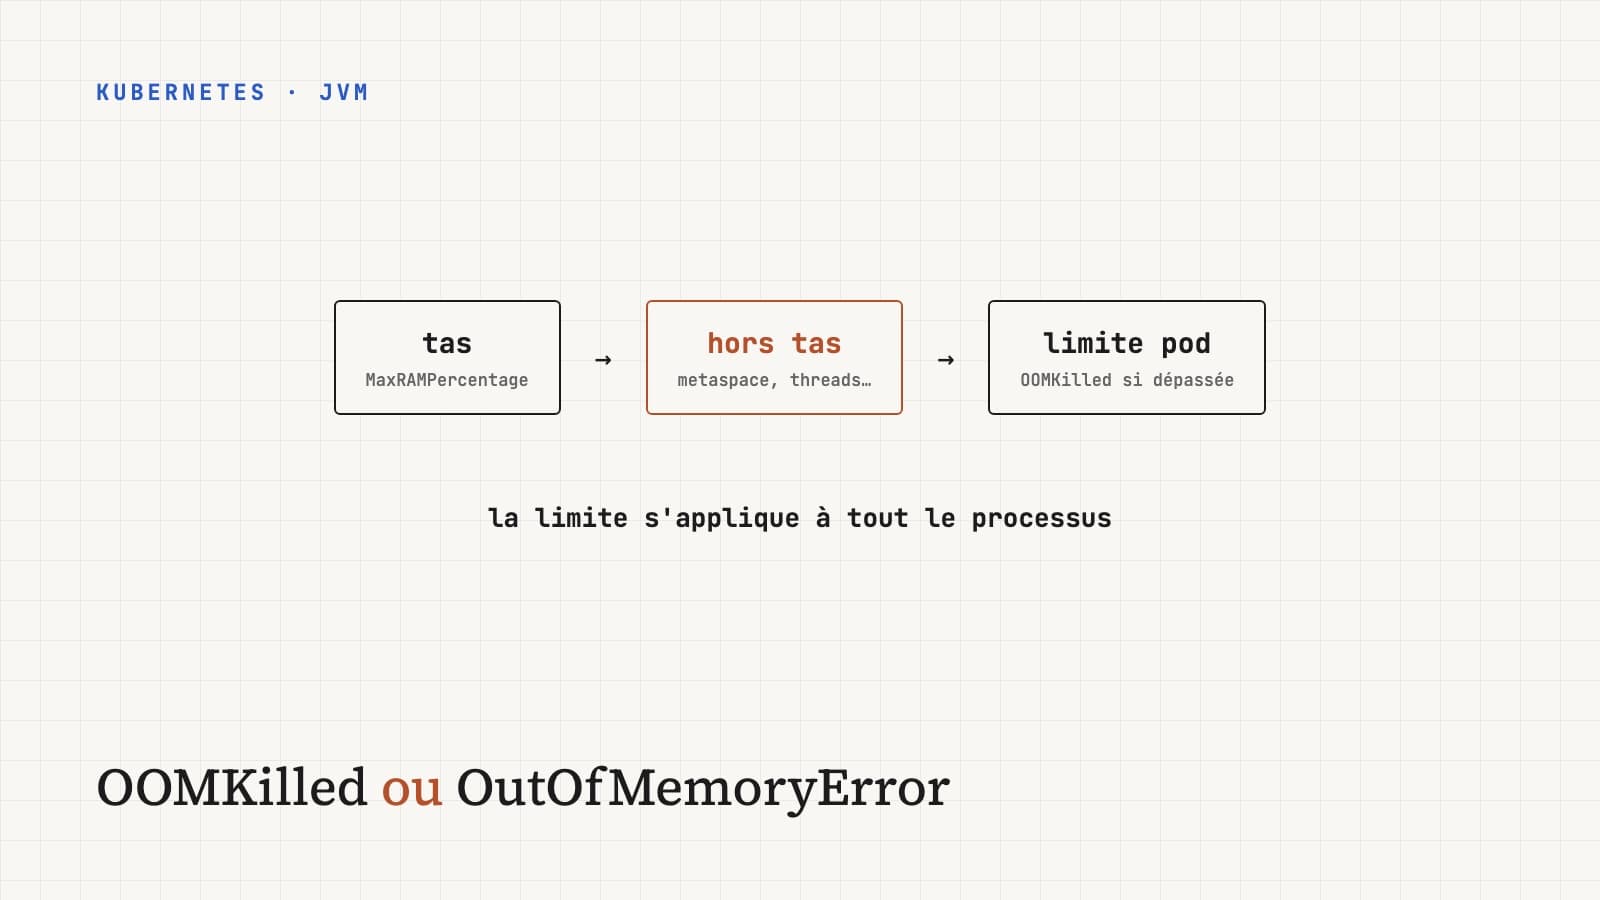
La différence essentielle est dans la deuxième ligne. -Xmx ou
MaxRAMPercentage limitent le tas. La limite Kubernetes s'applique à
tout le processus. Tout ce que la JVM consomme en plus du tas compte
pour Kubernetes et pas pour la JVM.
Conséquence pratique : -XX:+HeapDumpOnOutOfMemoryError ne sert à rien
contre un OOMKilled. Le processus est tué par le noyau sans prévenir, il
n'a pas le temps d'écrire quoi que ce soit.
Ce que la JVM consomme en dehors du tas#
┌────────────────── limite du conteneur : 1 Gi ──────────────────┐
│ Tas (heap)                     │ Hors tas                       │
│ MaxRAMPercentage=75 → 768 Mi   │ metaspace, code cache,         │
│                                │ piles des threads, GC,         │
│                                │ buffers directs, libs natives  │
└────────────────────────────────┴────────────────────────────────┘
                                   ▲
                    il reste 256 Mi pour tout ça
Les postes principaux, avec des ordres de grandeur pour un service Spring Boot typique :
- Metaspace : les métadonnées des classes chargées. Un service Spring Boot avec Hibernate et quelques starters charge facilement 20 000 classes, soit 100 à 200 Mo. Non plafonné par défaut.
- Code cache : le code compilé par le JIT. Jusqu'à 240 Mo réservés, souvent 50 à 100 Mo réellement utilisés.
- Piles des threads : environ 1 Mo réservé par thread par défaut
(
-Xss). 200 threads Tomcat plus les pools de connexion, les threads Kafka et ceux du GC, et on dépasse vite 200 Mo réservés, même si seule une partie est réellement utilisée. - Structures du GC : G1 consomme de la mémoire pour ses propres structures, de l'ordre de quelques pourcents du tas.
- Buffers directs : Netty, les clients HTTP réactifs, certains drivers
allouent hors tas (
ByteBuffer.allocateDirect). Par défaut, la limite est égale à la taille maximale du tas. - Bibliothèques natives et allocateur : compression, TLS, et la fragmentation de l'allocateur mémoire de la libc, qui peut à elle seule représenter des dizaines de mégaoctets sur un processus très multithreadé.
Additionné, le hors tas d'un service Spring Boot ordinaire se situe souvent entre 250 et 400 Mo. Avec une limite à 1 Gi et 75 % pour le tas, il reste 256 Mo : on est exactement dans la zone où le pod tient la plupart du temps, puis meurt quand le metaspace, les threads et les buffers montent en même temps sous la charge.
Mesurer au lieu de deviner#
La JVM sait détailler sa propre consommation, à condition de le lui demander au démarrage :
-XX:NativeMemoryTracking=summary
Puis, sur le pod en marche :
kubectl exec -it api-7d9f-xk2p -- jcmd 1 VM.native_memory summaryTotal: reserved=2143MB, committed=931MB
- Java Heap (reserved=768MB, committed=512MB)
- Class (reserved=1105MB, committed=182MB)
- Thread (reserved=231MB, committed=231MB)
- Code (reserved=247MB, committed=74MB)
- GC (reserved=96MB, committed=71MB)
- Internal (reserved=5MB, committed=5MB)
- Other (reserved=34MB, committed=34MB)
La colonne qui compte est committed : c'est la mémoire réellement demandée au système. Ici, 931 Mo pour un conteneur limité à 1 Gi, avec un tas qui n'est pourtant qu'à 512 Mo. Le problème saute aux yeux : 230 Mo de threads et 180 Mo de classes.
Deux précisions. NMT ne voit pas tout : les allocations faites par des
bibliothèques natives en dehors de la JVM et la fragmentation de
l'allocateur n'y apparaissent pas. La métrique Kubernetes
container_memory_working_set_bytes, celle que le noyau compare à la limite,
sera donc un peu plus haute. Et NMT a un léger coût : je l'active pour
diagnostiquer, pas en permanence.
Corriger : réduire le hors tas ou laisser plus de marge#
Une fois la mesure faite, les leviers sont connus.
Laisser plus de place au hors tas. 75 % convient pour des conteneurs de 2 Gi et plus. Pour 512 Mi ou 1 Gi, 60 à 65 % est souvent plus réaliste, ou alors une taille de tas fixe calculée à partir de la mesure NMT.
Plafonner ce qui peut l'être, pour que la croissance produise une
erreur explicite de la JVM plutôt qu'un OOMKilled silencieux :
-XX:MaxRAMPercentage=65
-XX:MaxMetaspaceSize=256m
-XX:ReservedCodeCacheSize=128m
-XX:MaxDirectMemorySize=128m
-Xss512k
Réduire -Xss n'est pas sans risque : un code très récursif peut
déclencher des StackOverflowError. 512 Ko suffisent pour la plupart des
services web, mais c'est à vérifier avec des tests de charge.
Réduire le nombre de threads. Un pool Tomcat à 200 threads dans un pod
limité à un CPU n'a pas de sens. Le ramener à 50, ou passer aux threads
virtuels (Java 21, spring.threads.virtual.enabled=true), dont les piles
vivent dans le tas et se dimensionnent à la demande, réduit directement le
poste « Thread ».
Requests et limits : ce que chaque valeur change#
Kubernetes s'appuie sur deux valeurs par ressource, et elles n'ont pas le même rôle.
- La request sert au placement : le scheduler ne met le pod que sur un nœud qui a cette quantité disponible. Elle ne limite rien à l'exécution.
- La limit est un plafond. Pour la mémoire, la dépasser, c'est
OOMKilled. Pour le CPU, la dépasser, c'est être ralenti (throttling).
Pour la mémoire d'une JVM, je mets request = limit. Une JVM ne rend presque jamais la mémoire du tas au système une fois qu'elle l'a prise. Si la request est plus basse que la limit, le pod peut être placé sur un nœud qui n'a pas réellement de quoi absorber sa consommation réelle, et il sera parmi les premiers tués quand le nœud manque de mémoire.
Pour le CPU, la question est plus discutée. Deux effets sont à connaître :
- la JVM calcule le nombre de threads du GC, du JIT et du
ForkJoinPoolcommun à partir du nombre de CPU qu'elle voit, déduit de la limit CPU (et non de la request, depuis Java 19) ; - avec moins de 2 CPU visibles, ou moins de 1 792 Mo de mémoire, la JVM choisit par défaut le Serial GC, peu adapté à un service web. Un pod à 1 Gi est donc concerné, quel que soit son nombre de CPU.
Un conteneur avec une limit CPU de 500m voit donc un seul processeur, tourne
avec le Serial GC, et subit du throttling au moindre pic, par exemple
pendant le démarrage de Spring qui compile énormément de code. Deux options
raisonnables : ne pas mettre de limit CPU et s'appuyer sur la request
(le pod profite du CPU libre du nœud), ou fixer une limit d'au moins 2 CPU.
Dans les deux cas, on peut forcer la valeur vue par la JVM avec
-XX:ActiveProcessorCount=2 et le GC avec -XX:+UseG1GC.
resources:
  requests:
    memory: "1Gi"
    cpu: "500m"
  limits:
    memory: "1Gi"
    # pas de limit CPU : le pod peut dépasser sa request quand le nœud a du CPU libre
env:
  - name: JAVA_TOOL_OPTIONS
    value: >-
      -XX:MaxRAMPercentage=65
      -XX:MaxMetaspaceSize=256m
      -XX:ActiveProcessorCount=2
      -XX:+UseG1GC
      -XX:+ExitOnOutOfMemoryError
-XX:+ExitOnOutOfMemoryError complète le dispositif : une JVM qui a subi
une OutOfMemoryError est souvent dans un état incohérent. La faire
s'arrêter proprement laisse Kubernetes la redémarrer, au lieu de la laisser
servir des erreurs pendant des heures.
La démarche en résumé#
- Identifier l'erreur :
OOMKilled(code 137 danskubectl describe pod) ouOutOfMemoryError(dans les logs). Ce ne sont pas les mêmes causes. - Pour une
OutOfMemoryError: heap dump et analyse du tas, comme décrit dans l'article sur le heap dump. - Pour un
OOMKilled: activer NMT, mesurer le hors tas sous charge réelle, comparer à la limite. - Ajuster : pourcentage du tas plus bas, plafonds sur metaspace, code cache et mémoire directe, moins de threads.
- Fixer request = limit pour la mémoire, et traiter le CPU en tenant compte de ce que la JVM en déduit.
Le réflexe « on augmente la limite à 2 Gi » règle souvent le symptôme, mais sans mesure, on ne sait pas si on a donné de la place au tas, qui n'en manquait pas, ou au hors tas, qui en manquait. Et on paie deux fois plus de mémoire par réplica pour un problème de 200 Mo.