Terraform en équipe : environnements, modules et CI sans se marcher dessus
L'article pour commencer Terraform s'arrête à deux règles : un state distant dès le premier jour, et un plan lu avant chaque apply. Elles suffisent tant qu'on est seul sur un seul environnement. Dès qu'une équipe de quatre personnes gère dev, préproduction et production, d'autres questions arrivent : comment séparer les environnements, comment partager du code sans tout coupler, qui a le droit de lancer un apply, et comment éviter qu'un secret finisse en clair quelque part. Cet article rassemble les pratiques qui tiennent quand l'équipe et l'infrastructure grandissent.
Un state par environnement, et par périmètre#
La première décision structure tout le reste : combien de states, et découpés comment.
Un state par environnement, au minimum. Si dev et production partagent
un state, un apply lancé pour tester une modification en dev peut
toucher la production. Le risque n'est pas théorique : il suffit d'une
variable mal renseignée.
Un state par périmètre, ensuite. Un seul state qui contient le réseau,
la base de données, le cluster Kubernetes et les 40 buckets de l'équipe
data a deux défauts. Chaque plan prend plusieurs minutes, et chaque
modification, même mineure, a pour rayon d'impact toute l'infrastructure.
Découper par cycle de vie limite ce rayon :
infra/
├── modules/
│   ├── network/
│   ├── postgres/
│   └── service/
└── live/
    ├── dev/
    │   ├── network/      ← change rarement
    │   ├── data/         ← base, buckets : change rarement, critique
    │   └── apps/         ← change souvent
    ├── preprod/
    │   └── …
    └── prod/
        └── …
Chaque dossier sous live/ a son propre backend et son propre state. Un
changement dans apps/ ne peut pas détruire la base, parce que la base
n'est pas dans ce state.
Les workspaces Terraform (terraform workspace new prod) semblent faits
pour séparer les environnements. HashiCorp déconseille pourtant de s'en
servir pour ça quand les environnements ont des droits d'accès différents :
tous les workspaces partagent le même backend et la même configuration, donc
les mêmes identifiants. Un dossier par environnement est plus verbeux, mais
chaque environnement peut avoir son propre compte cloud et ses propres
permissions.
Le state distant doit aussi être verrouillé. Sur S3, les versions récentes
de Terraform (1.10 et suivantes) savent poser le verrou directement dans le
bucket avec use_lockfile = true, ce qui rend la table DynamoDB inutile.
Sur GCS et Azure Blob, le verrouillage est natif.
terraform {
  backend "s3" {
    bucket       = "acme-terraform-state"
    key          = "prod/apps/terraform.tfstate"
    region       = "eu-west-3"
    encrypt      = true
    use_lockfile = true
  }
}
Les modules : partager sans coupler#
Un module est une fonction : des variables en entrée, des ressources, des outputs en sortie. Les mêmes règles de conception s'appliquent.
Un module doit faire une chose. Un module service qui crée un
déploiement, son équilibreur de charge et son enregistrement DNS est
cohérent. Un module plateforme qui crée aussi la base, le cache et la file
de messages devient impossible à réutiliser partiellement, et chaque
modification touche tous ses utilisateurs.
Peu de variables, avec des valeurs par défaut sensées. Un module avec 60 variables n'abstrait rien : il déplace la complexité. Les options que personne ne change deviennent des valeurs fixées dans le module.
Des versions figées. Un environnement doit pointer vers une version précise d'un module, pas vers la branche principale :
module "api" {
  source = "git::https://github.com/acme/terraform-modules.git//service?ref=v2.3.0"

  name          = "api-facturation"
  image         = var.image
  replicas      = 3
  cpu           = "500m"
  memory        = "1Gi"
}
Avec ?ref=v2.3.0, une modification du module ne change rien tant qu'on
n'a pas explicitement monté la version. On peut alors promouvoir la montée
de version environnement par environnement, comme n'importe quel
changement de code : dev d'abord, puis préproduction, puis production.
Même règle pour les providers : un fichier .terraform.lock.hcl commité
dans le repo garantit que tout le monde, CI comprise, emploie exactement la
même version.
Le plan en CI, l'apply par la CI#
À plusieurs, lancer terraform apply depuis un poste de développeur pose
trois problèmes : personne ne sait ce qui a été appliqué, les versions
locales diffèrent, et les identifiants de production traînent sur des
laptops. Le flux qui règle les trois :
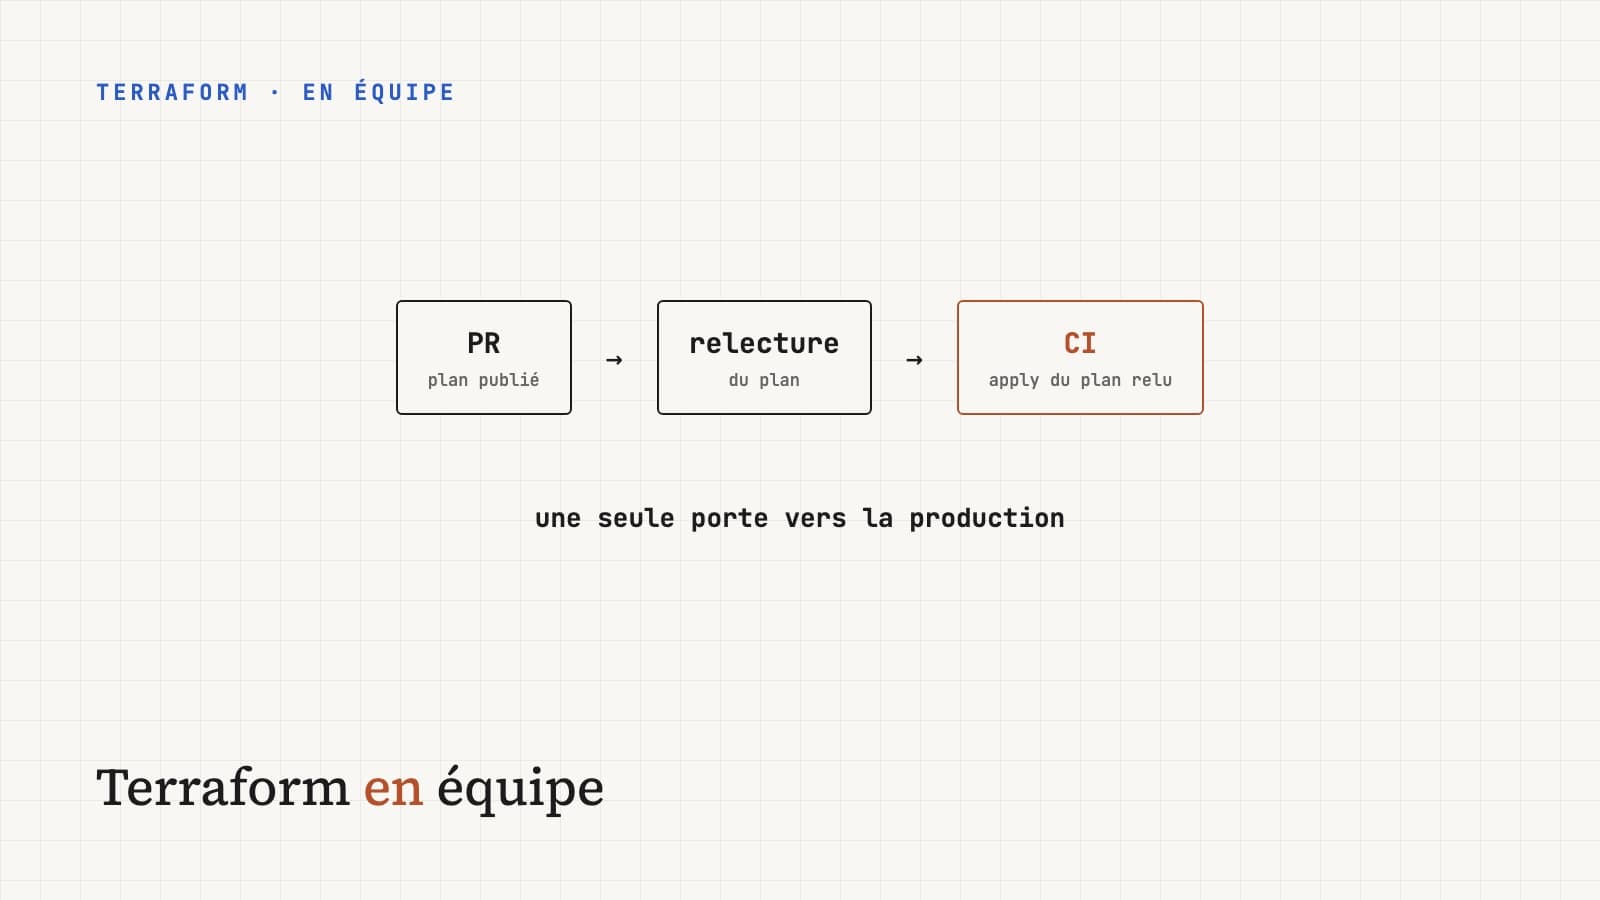
 PR ouverte ──▶ CI : fmt, validate, plan ──▶ plan publié en commentaire de la PR
                                                         │
                                               relecture du plan (pas que du code)
                                                         │
 merge ──▶ CI : apply du plan relu ◀─────────────────────┘
Deux points font la différence.
On relit le plan, pas seulement le diff HCL. Un diff de deux lignes peut produire un plan qui détruit et recrée une base, comme le montre le tableau des symboles dans l'article d'introduction. Le plan en commentaire de PR met cette information sous les yeux du relecteur.
On applique le plan qui a été relu. terraform plan -out=tfplan produit
un fichier ; terraform apply tfplan applique exactement ce fichier, sans
recalculer. Si le state a été modifié entre-temps (par un autre apply, par
exemple), Terraform refuse ce plan périmé au lieu d'appliquer autre chose
que ce qui a été validé.
terraform plan -input=false -out=tfplan
terraform show -no-color tfplan > plan.txt   # pour le commentaire de PR
# … après merge :
terraform apply -input=false tfplan
Les identifiants de production ne sont alors plus que dans la CI. Idéalement, même pas sous forme de clé : GitHub Actions, GitLab CI et les principaux clouds savent s'authentifier par OIDC, avec des identifiants temporaires obtenus à chaque exécution.
Les secrets : le state n'est pas un coffre#
Le piège le plus sous-estimé : le state contient les valeurs des
ressources en clair, y compris les mots de passe de base générés, les clés
d'accès créées, les certificats. Marquer une variable sensitive = true la
masque dans la sortie du plan, pas dans le state.
Les règles qui en découlent :
- le bucket de state est chiffré, versionné, et son accès est restreint à la CI et à une poignée de personnes ;
- les secrets ne sont pas passés en variables dans des fichiers
.tfvarscommités ; - quand c'est possible, Terraform crée l'emplacement du secret (une entrée dans Secrets Manager, Vault ou Key Vault) et c'est l'application qui lit la valeur au démarrage, sans qu'elle transite par Terraform ;
- les versions récentes de Terraform proposent des valeurs éphémères, qui ne sont jamais écrites dans le state, pour les cas où Terraform doit manipuler un secret sans le conserver.
Refactorer sans détruire#
Renommer une ressource ou la déplacer dans un module ressemble à un refactoring anodin. Pour Terraform, c'est une ressource supprimée et une nouvelle ressource créée : le plan propose de détruire la base de production et d'en créer une vide.
Le bloc moved indique à Terraform qu'il s'agit de la même ressource :
moved {
  from = aws_db_instance.main
  to   = module.postgres.aws_db_instance.this
}
Le plan affiche alors un déplacement dans le state, sans aucune action sur
l'infrastructure. Même idée pour reprendre une ressource créée à la main :
un bloc import dans le code plutôt qu'une commande terraform import
lancée depuis un poste, pour que l'opération passe par la relecture et la
CI comme le reste.
La dérive : la détecter plutôt que la subir#
Quelqu'un modifie une règle de pare-feu dans la console pendant un incident, et oublie de reporter le changement dans le code. Au prochain apply, Terraform annule la modification, éventuellement au pire moment.
Un job planifié qui lance terraform plan -detailed-exitcode chaque nuit
sur chaque state détecte cette dérive : le code de sortie vaut 2 quand le
plan n'est pas vide. On reçoit l'alerte le lendemain matin, et on décide
calmement s'il faut reporter la modification dans le code ou l'annuler.
terraform apply -target=... applique une partie seulement du plan. C'est
utile pour sortir d'une situation bloquée, mais en faire une habitude laisse
le state dans un état que le code ne décrit plus entièrement. Si un
-target devient nécessaire régulièrement, c'est en général le signe que
le state est trop gros et qu'il faut le découper.
La checklist d'équipe#
- Un state par environnement et par périmètre, chacun avec son backend.
- Verrouillage du state actif (
use_lockfilesur S3, natif ailleurs). - Modules versionnés, référencés avec
?ref=vers un tag. -
.terraform.lock.hclcommité. - Plan publié sur chaque PR, apply uniquement par la CI, à partir du plan relu.
- Authentification de la CI par OIDC plutôt que par clés longues.
- Bucket de state chiffré, versionné et à accès restreint.
- Aucun secret dans les
.tfvarscommités. - Blocs
movedetimportplutôt que des commandes manuelles. - Détection de dérive planifiée.
Ce qu'il faut retenir#
Terraform en équipe ne demande pas d'outil supplémentaire, il demande de traiter l'infrastructure comme du code de production : des frontières claires (un state par périmètre), des dépendances versionnées (modules et providers), une seule porte d'entrée vers la production (la CI), et une relecture qui porte sur l'effet réel (le plan) plutôt que sur le texte (le HCL). Chacune de ces pratiques coûte un peu de mise en place. Aucune ne coûte autant qu'une base de production recréée vide un vendredi soir.